Видео с ютуба Ai Model Compression

LLM Compression Explained: Build Faster, Efficient AI Models

Квантование против обрезки против дистилляции: оптимизация нейронных сетей для вывода

Compression at the Edge — NVIDIA, Unsloth, HuggingFace, Ollama

Model Compression Explained: Making AI Smaller & Faster 🚀

Mentor Palokaj: AI Model Compression & Quantization | TPN, Bittensor Subnet 65 | Ep. 106

Adaptive Soft-Thresholding for Hardware-Aligned Model Compression | Ayoub Ghriss | Random Samples

What is AI (or #LLMs )Model Compression?

Model Compression Techniques for Edge AI
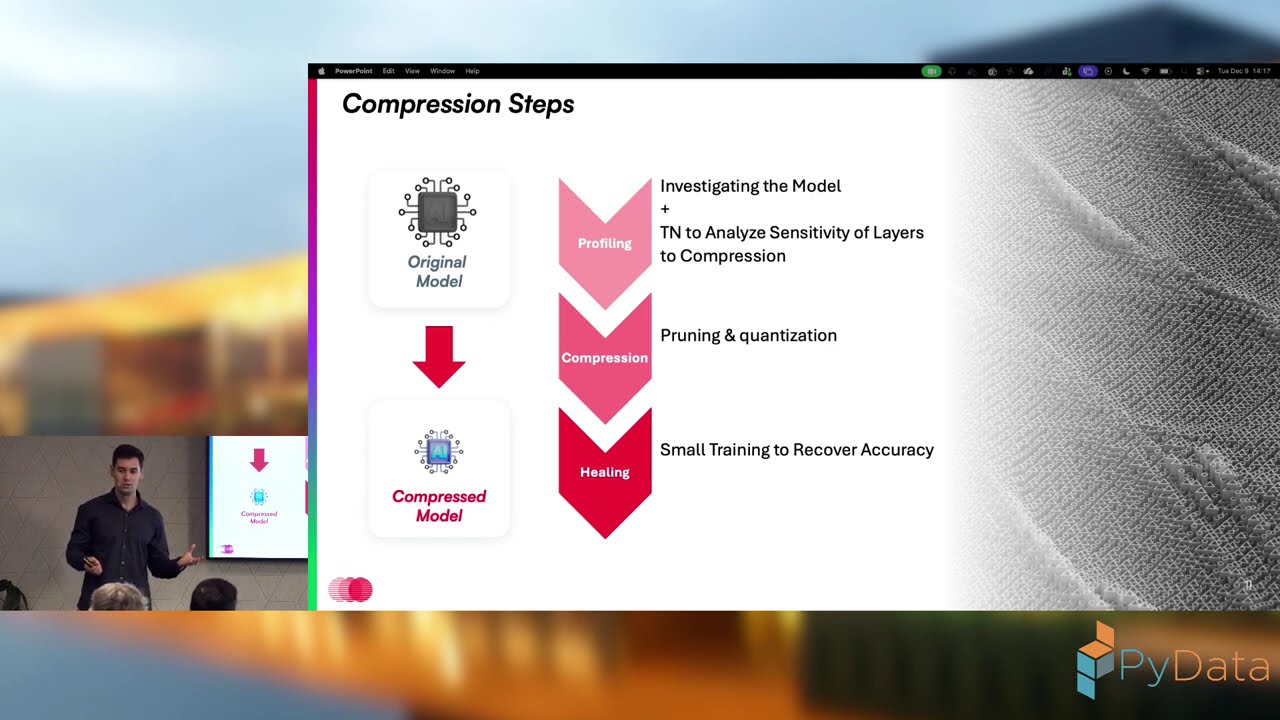
Jon Leiñena Otamendi - CompactifAI: Quantum-Inspired AI Model Compression - PyData Eindhoven 2025

Сжатие: ментальная модель ИИ №5

Neural Network Pruning for Compression & Understanding | Facebook AI Research | Dr. Michela Paganini

Compressing Neural Networks for Embedded AI: Pruning, Projection, and Quantization
Compressing Large Language Models (LLMs) | w/ Python Code

How to make Big AI models fit on small hardware

Knowledge Distillation Explained | AI Model Compression Tutorial

What Is Quantization? How AI Models Get Smaller & Faster
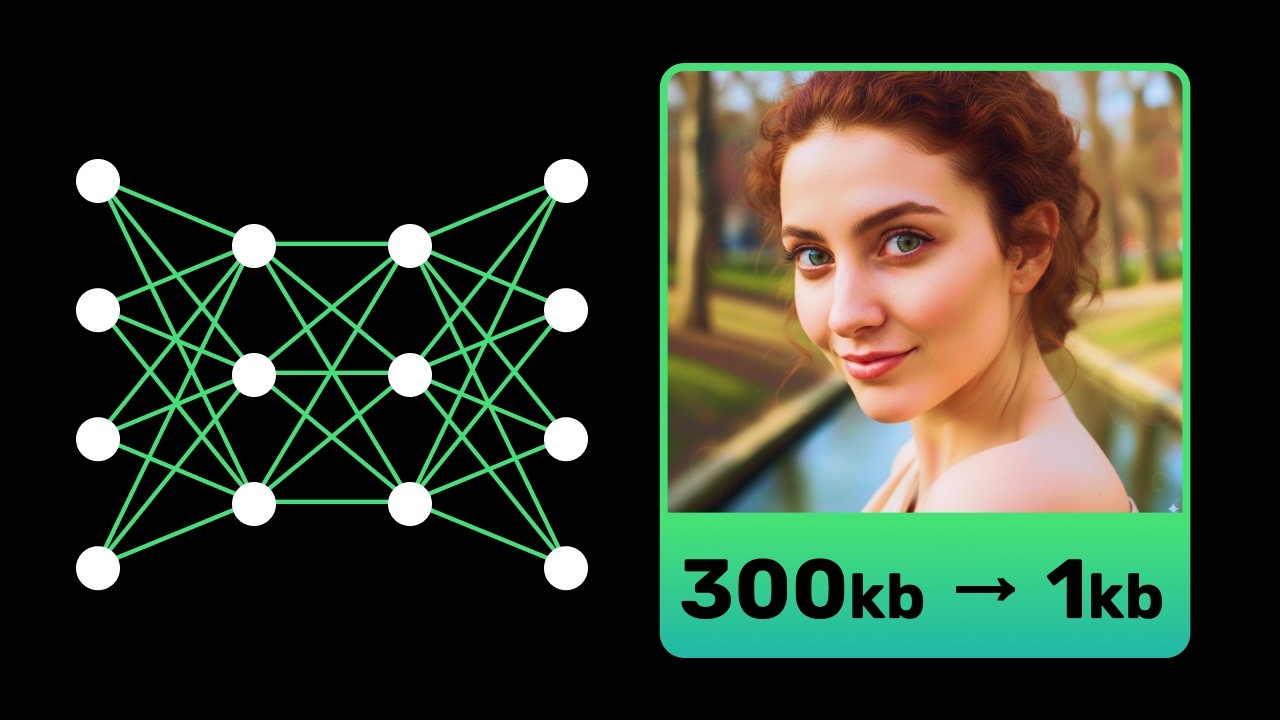
AI Compression is 300x Better (but we don't use it)
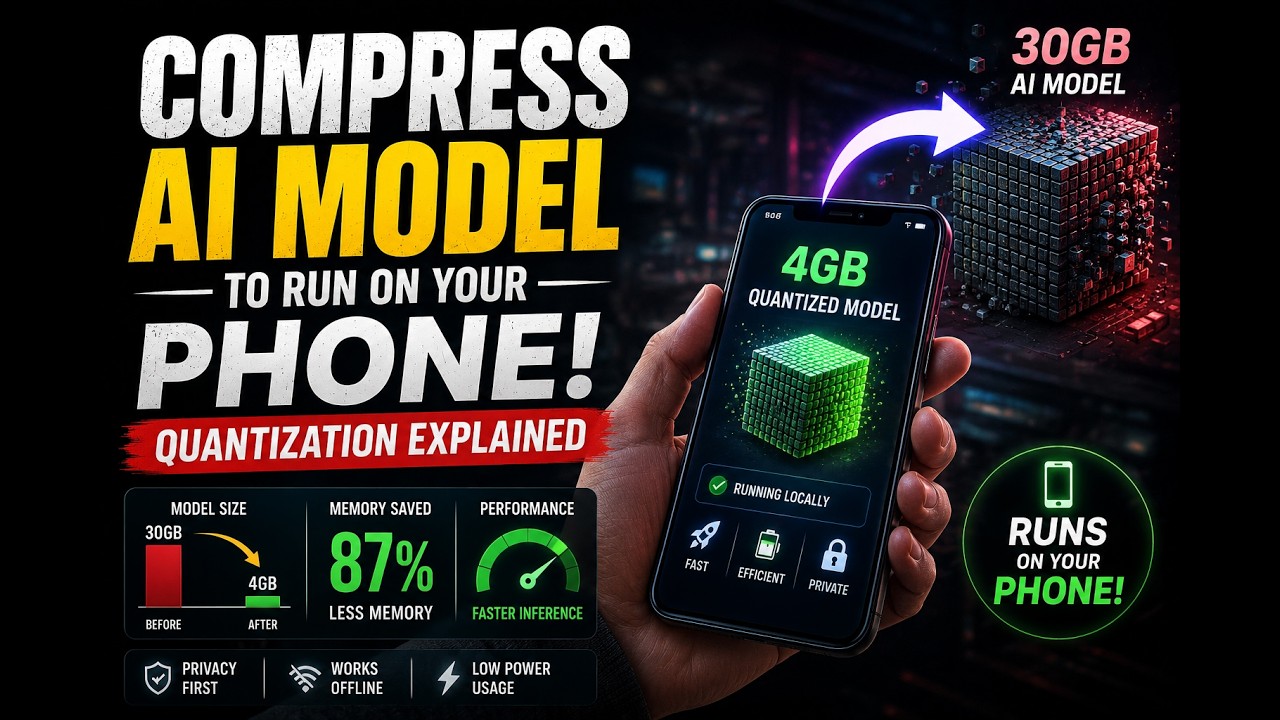
Как сжать ИИ-модель для запуска на телефоне (объяснение квантования)

Model Compression & Optimization: Making AI Models Faster | #GirlsWhoML

Майкл Фридман: Сжатие — это всё, что вам нужно.